Le règlement européen sur l’Intelligence Artificielle est désormais une réalité. Si certaines exigences de fond ont été décalées, l’essentiel du cadre réglementaire est déjà actif. Le report obtenu cet été n’a libéré personne : bâtir une IA conforme à l’AI Act est un chantier qui commence dès aujourd’hui, et il commence par la donnée.
Pour décrypter les véritables impacts de ce règlement pour les entreprises françaises et comprendre quelles étapes suivre pour mettre vos algorithmes en conformité d’ici 2027, notre expert Data & IA chez Amoddex, Thomas CAUHAPE partage son regard terrain sur la méthode à adopter.
L’AI Act s’applique progressivement jusqu’en 2027. Pourquoi s’y préparer dès aujourd’hui ?
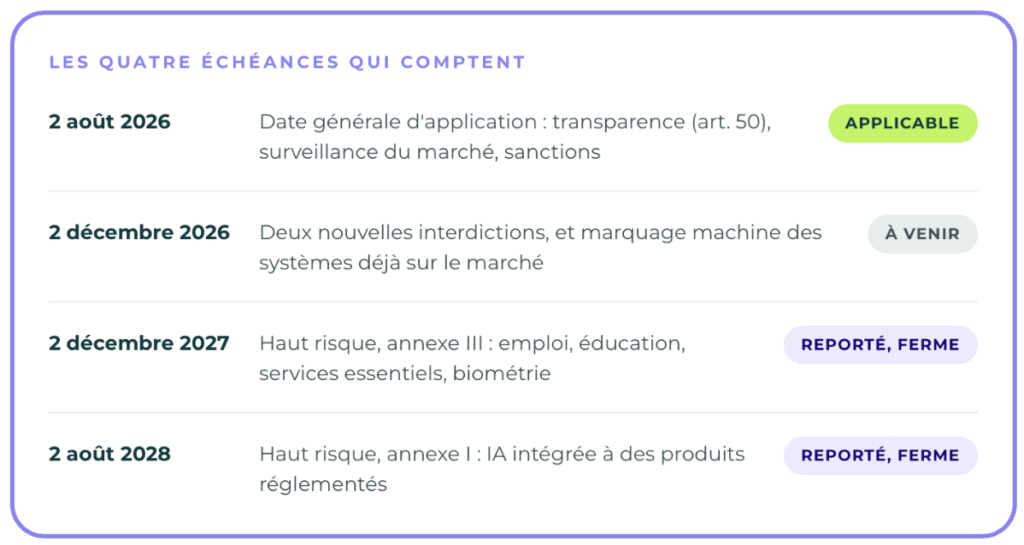
C’est une question que l’on me pose très souvent en ce moment. Le règlement (UE) 2026/1744, dit Digital Omnibus sur l’IA, est entré en vigueur le 27 juillet 2026. S’il repousse les exigences de fond sur le haut risque à décembre 2027 (pour l’annexe III) et à août 2028 (pour l’annexe I), rien d’autre n’a bougé.
Depuis le 2 août 2026, les obligations de transparence, la surveillance du marché et le régime de sanctions s’appliquent déjà. Or, ces exigences de transparence ne dépendent pas du niveau de risque, mais de la situation d’usage (interaction avec des personnes, génération de contenus synthétiques, reconnaissance d’émotions, deepfakes). Autrement dit, elles couvrent la quasi-totalité des utilisateurs d’IA générative, y compris ceux qui ne feront jamais de haut risque. Le projet initial conditionnait le report à la disponibilité des normes harmonisées, mais le texte final a supprimé ce mécanisme. En résumé, le report a déplacé la date de l’examen, pas le programme.
Par ailleurs, le contrôle a déjà commencé par d’autres canaux. Le plan de contrôle 2026 de la CNIL cible par exemple le recrutement, une thématique qui préfigure ses futures attributions de surveillance du marché. Les sanctions prévues atteignent certes 35 millions d’euros ou 7 % du chiffre d’affaires mondial pour les pratiques interdites mais ce n’est pas le levier le plus parlant, selon moi. Attendre 2027, c’est surtout prendre le risque de déployer aujourd’hui des systèmes en production qu’il faudra débrancher demain : le vrai coût est là.
Comment identifier les systèmes et usages de l’IA réellement concernés ?
Dans ma démarche d’accompagnement, je dis souvent que la bonne entrée n’est pas l’application du règlement, c’est la réalisation de l’inventaire de l’usage de l’IA dans l’entreprise. La question utile n’est pas « sommes-nous concernés ? », c’est « qu’est-ce qui tourne chez nous ? ».
En 2025, 18 % des entreprises implantées en France déclaraient utiliser au moins une technologie d’IA (contre 6 % en 2023). Pourtant, sur le terrain, trois angles morts reviennent systématiquement :
- L’IA embarquée dans des logiciels métier déjà en place (souvent activée par une simple mise à jour).
- Les outils adoptés directement par les équipes en « Shadow IT ».
- Les briques d’IA contenues dans des prestations externalisées.
Reconstituer cet inventaire sur des systèmes en production demande un certain temps. Une fois cet inventaire réalisé, deux qualifications viennent avant tout le reste.
D’abord, le rôle : êtes-vous fournisseur ou déployeur ? Les obligations ne sont pas les mêmes, d’autant que ce statut n’est pas figé. Le simple fait de personnaliser substantiellement un système acheté comme adapter un chatbot pour un autre usage ou de le commercialiser sous votre propre marque vous fait passer de déployeur à fournisseur. Ensuite, la finalité : c’est elle qui détermine le niveau de risque, et non la technologie en elle-même.
Une fois cartographiés, il faut comprendre que le niveau de risque se lit dans la finalité, pas dans la technologie. Le même modèle linguistique est anodin dans une aide à la rédaction, mais devient « à haut risque » s’il trie des candidatures. Évaluer sa maturité data en amont est donc indispensable pour cartographier, sécuriser et déployer une IA conforme à l’AI Act.
Comment savoir si votre patrimoine data est prêt pour l’IA ?
Évaluez la maturité de votre patrimoine data en quelques minutes et obtenez un diagnostic personnalisé pour sécuriser vos futurs déploiements.
Quel rôle joue la gouvernance des données pour une IA conforme à l’AI Act ?
Ce que le règlement demande pour un système à haut risque (gouvernance des données, documentation technique, journalisation, contrôle humain, exactitude) relève majoritairement de sujets Data, et non de sujets purement juridiques. Pour moi, le constat est simple : un système d’IA n’est jamais plus conforme que les données qui l’alimentent.
Un jeu de données non documenté rend la conformité indémontrable. Ce n’est pas qu’une question de performance technique, c’est une question de preuve.
Sur l’IA générative en particulier, je vois souvent revenir deux points aveugles chez nos clients :
- Le versioning : plusieurs versions d’un même document faussent la restitution. Personne ne sait laquelle a produit la réponse.
- Le lexique : deux services qui nomment différemment la même chose obtiennent des réponses contradictoires de la part de l’IA.
D’où la position que nous défendons au quotidien chez Amoddex : la gouvernance de la donnée est un prérequis au déploiement de l’IA et pour la rendre conforme à l’AI Act. Mais au-delà de la stricte conformité réglementaire, les entreprises doivent garantir un contrôle total et durable sur leur patrimoine informationnel : c’est là que les enjeux de souveraineté deviennent indissociables de la démarche. Cette gouvernance ne doit donc pas être une simple couche de vernis ajoutée après coup.
Concrètement, comment prouver la maîtrise et la traçabilité de ces données ?
J’explique souvent que garantir une IA conforme à l’AI Act, c’est produire des pièces factuelles, pas seulement tenir un discours. Cela repose sur deux piliers : le socle documentaire et l’architecture technique.
Les quatre pièces du dossier
Pour rendre une sortie d’IA opposable et justifiable, voici les quatre éléments que je juge indispensables :
- La cartographie des données et des flux : Quelles sources ? Quels systèmes ? Quels transferts ? Centralisée au sein d’un catalogue de données, elle est le socle sur lequel reposent toutes les autres pièces.
- Le dictionnaire de données : Il fige les définitions, les propriétaires, les règles de gestion et les formules de calcul.
- La classification et la base légale : Données personnelles, données sensibles, durées de conservation. C’est un recoupement direct avec le RGPD (du travail qui sert deux fois).
- La journalisation : Quelle version du modèle a été utilisée ? Quelles données en entrée ? Quelle sortie ? Qui a validé ? Le contrôle humain n’est démontrable que s’il est tracé.
À quel moment chaque pièce se fabrique ?
Ces livrables se posent sur une architecture technique (souvent en médaillon) :
- BRONZE : Le référentiel de toutes les sources possibles ou autrement dit, l’étape où l’on collecte tout.
- SILVER : Le catalogue des données critiques et propres (celles qui alimentent l’IA) c’est-à-dire le niveau où l’on ne garde que ce qui est propre et critique.
- GOLD : Le schéma en étoile, le dictionnaire et les formules de calcul, concrètement on met un nom, une définition et une formule sur chaque indicateur. Selon moi, une IA ne devrait d’ailleurs jamais être branchée en amont du GOLD.
Cependant, la technique ne dit pas quoi gouverner. Je le constate à chaque mission : la gouvernance se décide à partir du métier : ce sont les définitions partagées et les propriétaires nommés qui produisent la qualité, pas l’outil technologique.
Comment organiser les responsabilités entre l’IT, la Data, les métiers et le juridique ?
Le vrai problème que je rencontre dans presque toutes les organisations n’est pas de trouver les compétences, c’est de nommer les décideurs. Beaucoup d’organisations ont toutes les expertises requises, mais personne qui tranche.
Trois décisions doivent être attribuées à une personne physique, pas à une direction : qui autorise la mise en service, qui a le pouvoir de l’arrêter, et qui répond en cas de contrôle.
Thomas CAUHAPE, expert Data & IA chez Amoddex
La répartition que je recommande et qui fonctionne sur le terrain suit les responsabilités réelles :
- Le métier porte la finalité et l’usage, c’est donc lui qui qualifie le risque.
- La Data porte les sources, la qualité et la traçabilité (le Data Owner est la clé de voûte).
- L’IT et la Cybersécurité portent l’exécution et la gestion des accès.
- Le Juridique et le DPO (Délégué à la Protection des Données) portent la qualification réglementaire.
Si vous confiez le sujet uniquement au juridique, vous obtiendrez une note sans traduction opérationnelle. Si vous le confiez uniquement à l’IT, cela génèrera des mesures techniques qui ne couvriront pas le risque métier réel. Un référentiel unique, partagé avec le RGPD, est le seul format soutenable.
Quelles sont les questions autour de la conformité et de la réglementation qui reviennent régulièrement dans vos échanges avec les clients ?
Sur le terrain, les équipes se posent beaucoup de questions très concrètes. Lors de mes interventions, certaines questions reviennent très fréquemment :
La première concerne le périmètre : « L’AI Act s’applique-t-il à mon entreprise si je n’utilise pas d’IA à haut risque ? ». La réponse est oui, dans la plupart des cas. Les obligations de transparence ne dépendent pas du niveau de risque, mais de la situation d’usage (interaction avec des personnes, génération de contenus, reconnaissance d’émotions, deepfakes). Elles couvrent la quasi-totalité des utilisateurs d’IA générative, y compris ceux qui ne feront jamais de haut risque.
Une autre question clé concerne le calendrier : « Quelles sont exactement les dates d’application de l’AI Act ? ». Il faut garder en tête que depuis le 2 août 2026, les obligations de transparence, la surveillance du marché et le régime de sanctions s’appliquent déjà. Seules les exigences de fond sur le haut risque ont été reportées au 2 décembre 2027 pour l’annexe III et au 2 août 2028 pour l’annexe I. Tout le reste est actif.
À ce sujet, on me demande souvent : « Le report de décembre 2027 peut-il être repoussé à nouveau ? ». Rien ne le laisse penser. Le texte final ayant supprimé le mécanisme de conditionnalité du projet initial, ces dates sont désormais fermes et définitives.
Côté usages du quotidien, une question revient à chaque fois : « Utiliser ChatGPT ou Copilot en entreprise relève-t-il de l’AI Act ? ». Absolument. Le simple fait de déployer un outil d’IA générative fait de l’entreprise un déployeur. Cela entraîne des obligations directes de transparence et de formation des collaborateurs à la maîtrise de l’IA. Le niveau de risque varie ensuite selon la finalité de l’usage.
On me sollicite aussi sur l’articulation réglementaire : « Quelle est la différence entre l’AI Act et le RGPD ? ». C’est très complémentaire : le RGPD encadre la protection des données personnelles, tandis que l’AI Act régule les systèmes d’IA selon leur finalité. En pratique, les deux textes se recoupent largement sur la cartographie, la classification des données et l’exigence de traçabilité.
Enfin, la question fondamentale reste : « Par où commencer pour rendre son IA conforme à l’AI Act ? ». Ma recommandation est constante : commencez par un inventaire exhaustif des outils et logiciels (en incluant l’IA embarquée et les usages Shadow IT), qualifiez chaque système selon son rôle et sa finalité, puis documentez rigoureusement les données qui les alimentent.
Comment faire de la conformité un réflexe quotidien pour les collaborateurs ?
L’omnibus de juillet 2026 a réécrit l’article 4 de l’AI Act : garantir un niveau suffisant de maîtrise de l’IA devient une obligation de moyens, notamment à travers des programmes pour développer ses compétences et suivre une formation IA.
La formation n’est pas un module que l’on place en fin de projet. Elle doit se construire par paliers (culture générale Data pour les directions, cadrage pour les métiers, formation technique pour les bâtisseurs) et intervenir en amont de la gouvernance. Une règle que l’on ne comprend pas est une règle que l’on contourne.
Pour ancrer les bons réflexes, l’interdiction stricte ne fonctionne pas : il faut fournir des alternatives cadrées pour éviter l’usage parallèle (le pire risque juridique).
Au quotidien, j’encourage les collaborateurs doivent se poser trois questions réflexes face à une IA :
- Des données de l’entreprise entrent-elles dedans, et lesquelles ?
- La sortie part-elle vers un tiers ?
- Est-ce qu’une décision est prise sur cette base, et par qui ?
Quelle serait votre feuille de route en 5 étapes pour une IA conforme à l’AI Act et les erreurs à éviter ?
Les organisations qui avaient construit leur conformité autour de la date de 2027 refont actuellement leur planning. Celles qui l’avaient construite autour d’une doctrine de gouvernance ont simplement plus de temps pour l’appliquer. Si je devais résumer la méthode que nous appliquons chez nos clients, voici les étapes que je préconise :
- Étape 1 : Inventorier ce qui tourne (y compris l’IA embarquée et l’usage « fantôme » des équipes).
- Étape 2 : Qualifier chaque système (rôle, finalité, niveau de risque. Produisez un tableau de suivi, pas un rapport de 50 pages).
- Étape 3 : Traiter la transparence tout de suite (c’est déjà exigible, peu coûteux, et un défaut d’affichage se voit de l’extérieur).
- Étape 4 : Documenter la donnée (cartographie, dictionnaire, journalisation. C’est ici que les mois gagnés sur le calendrier sont utiles).
- Étape 5 : Installer le régime de gouvernance (responsabilités nommées, référentiel unique RGPD/AI Act).
Si cette feuille de route donne un cap clair, son exécution sur le terrain se heurte souvent à de mauvaises pratiques qui peuvent rapidement fragiliser tout le dispositif. Pour sécuriser votre démarche, voici les erreurs classiques que je vois trop souvent et qu’il faut absolument éviter :
- Lire « report » et comprendre « dispense ».
- Croire que ne pas faire de « haut risque » exonère de toute obligation.
- Penser que la conformité est uniquement le problème de l’éditeur du logiciel.
- Mener deux chantiers séparés en silos (un pour le RGPD, un pour l’AI Act).
- Commencer par choisir l’outil d’IA, sans avoir nommé de Data Owners ni partagé de définitions communes.
En définitive, je suis convaincu qu’ aucune de ces étapes ne se règle avec un outil. Bâtir une IA conforme à l’AI Act exige avant tout des définitions partagées, des propriétaires nommés et des traces rigoureusement conservées. Mais au-delà de la contrainte réglementaire, ce chantier est surtout l’opportunité de passer d’une « donnée subie » à une « donnée maîtrisée ». C’est tout le sens de notre approche Data 360° chez Amoddex : faire de votre patrimoine data un socle de confiance durable, véritable carburant de votre performance et de vos futurs usages IA.